Устаревшие системы с ограниченной поддержкой
Дублирование ИТ-систем
Поддержка обходится дороже, чем нужно
Чек-ап ИТ-ландшафта
Что можно проверить своими силами
Компании сейчас осторожнее относятся к крупным инвестпроектам: деньги дорогие, свободных бюджетов немного. При этом потребность в операционной эффективности никуда не делась: нужно выпускать больше при тех же ресурсах, снижать себестоимость, точнее планировать производство и загрузку оборудования.
В этих условиях предприятия делают ставку на точечные проекты цифровизации — запускают их там, где есть понятная потребность и можно заранее оценить экономический эффект. Автоматизируют отдельные операции, внедряют системы управления производством, инструменты планирования и другие решения. При ограниченных бюджетах особенно важно, чтобы каждый такой проект давал измеримый результат.
Но перед очередным внедрением стоит посмотреть, что происходит с ИТ-ландшафтом, который уже есть у компании. В нём могут быть скрыты проблемы и потери, которые либо снизят результат нового проекта, либо вообще заставят иначе расставить инвестиционные приоритеты.
На основе опыта проектов компании «Инфосистемы Джет» разберём три типовых источника таких потерь и покажем, к чему они приводят.
Очень распространённая история — системы на устаревшем технологическом стеке, которые поддерживаются силами одного-двух специалистов или внешним подрядчиком.
Как правило, это самописные решения либо продукты вендоров, которые ушли с рынка. Компании продолжают работать на таких системах, ведь они могут закрывать критичные бизнес-задачи — например, управление транспортом или цепочкой поставок.
При штатной работе проблем может не быть, поэтому у бизнеса (на первый взгляд) нет повода считать такую систему приоритетной для замены. Риск становится заметен, если от неё зависит критичный процесс, а после серьёзного сбоя быстро восстановить её невозможно.
Например, у компании есть ИТ-решение, которое формирует путевые листы и наряд-задания для транспорта. Пока оно работает, документы выпускаются, машины ездят, всё выглядит благополучно. Но если в случае отказа систему не удастся быстро восстановить, транспорт перестанет получать задания и документы — работа парка остановится.
Ещё один сценарий — киберинцидент. Классические решения катастрофоустойчивости проектировались под физические аварии: пожар, затопление, потерю питания. Сегодня нужно учитывать и атаки, при которых данные могут быть зашифрованы или уничтожены.
Поэтому для критичных систем важно отдельно оценивать непрерывность:
Это напрямую влияет на инвестиционные приоритеты. Компания, скажем, планирует внедрение машинного зрения или искусственного интеллекта для повышения операционной эффективности.
Но аудит показывает, что критичный процесс зависит от устаревшей системы, которую сложно восстановить после сбоя. Тогда риск остановки уже работающего процесса приходится учитывать наряду с эффектом от нового проекта. И если этот риск высок, модернизация или замена существующей системы может подняться выше в инвестиционном портфеле.
Дублирование решений — проблема прежде всего разветвлённых структур: производственных холдингов, групп компаний с десятками площадок. Хотя встречается она и на отдельных предприятиях.
Представьте крупную компанию, у которой девять заводов с географией от Санкт-Петербурга до Комсомольска-на-Амуре. Площадки самостоятельно подбирают ИТ-инструменты под свои процессы: изучают рынок, сравнивают продукты и внедряют подходящий вариант.
Локально всё выглядит рационально. Но на уровне холдинга может оказаться, что одну и ту же функцию выполняют несколько систем одного класса — например, семь разных MES (систем управления производством).
Кстати, с такой ситуацией мы столкнулись при аудите одного машиностроительного холдинга: на его предприятиях одновременно использовалось несколько MES и систем планирования, и за каждую компания отдельно платила вендору.
В масштабе всей группы эти расходы складываются в существенную сумму.
При этом консолидация — это не просто отказ от нескольких лицензий. Системы имеют разную архитектуру, интеграции и накопленную бизнес-логику, поэтому переход на единый контур сам по себе требует отдельного проекта и инвестиций. Экономический эффект появляется после миграции: уменьшается число поддерживаемых платформ, лицензионных договоров и отдельных сервисных команд.
Есть и архитектурный эффект. Когда одна и та же функция реализована на разных платформах, проекты уровня всего холдинга — например, сквозная аналитика или единое планирование — приходится строить поверх неоднородного ИТ-ландшафта. Чем меньше таких различий, тем проще развивать общие сервисы и данные.
Поэтому перед очередным внедрением полезно проверить не только стоимость нового решения, но и то, нельзя ли получить часть необходимого эффекта за счёт упрощения уже существующего ландшафта. Иногда источник экономии находится не в новом проекте, а в расходах, которые компания исторически продолжает нести на параллельные системы.
Читайте также

Ещё один источник скрытых затрат связан с совокупной стоимостью владения системой. Её обычно считают при внедрении, но затем не всегда пересматривают по мере того, как меняется сама система и нагрузка на неё.
Совокупная стоимость владения, или TCO, включает расходы на систему:
Например, предприятие внедряет MES и на старте закладывает определённые затраты на инфраструктуру и сопровождение. После запуска нагрузка на поддержку может вырасти: пользователи осваивают новый инструмент, появляются вопросы и доработки, поэтому сервисную линию усиливают дополнительными специалистами и переводят на режим 24/7.
На этом этапе дополнительные расходы оправданы. Но со временем система стабилизируется, основные доработки заканчиваются, пользователи привыкают к ней, а количество обращений снижается. При этом модель поддержки часто остаётся той же, что была в период пиковой нагрузки.
Для компании это уже заметные деньги.
Для этого достаточно посмотреть историю обращений в поддержку и требования SLA: сколько обращений действительно поступает, какой у них приоритет и какой объём работы приходится на поддержку. Так становится видно, соответствует ли действующая сервисная модель реальной потребности бизнеса. В некоторых случаях выясняется, что нагрузка давно снизилась, а компания продолжает оплачивать поддержку в прежнем объёме.
По тому же принципу стоит проверять и другие регулярные расходы на ИТ.
В одном из проектов при инвентаризации обнаружились сразу три информационные системы, которыми компания фактически не пользовалась больше года. Значительная часть решений относилась к специализированному инженерному ПО, но лицензии и поддержка продолжали ежегодно оплачиваться. После вывода этих систем из эксплуатации удалось высвободить около 4,5 млн рублей в год.
Такие расходы легко сохраняются по инерции. Бизнес перестал пользоваться системой, ИТ об этом не узнало или не пересмотрело договор, очередное продление прошло автоматически — и строчка остаётся в бюджете ещё несколько лет.
Поэтому финансовый контроль ИТ-затрат — это не только проверка крупных инвестиций. Не менее важно регулярно сверять текущие платежи с тем, насколько система действительно используется и какую ценность продолжает приносить бизнесу.
Три примера выше — только часть проблем, которые могут быть спрятаны в ИТ-ландшафте. Чтобы увидеть их системно и понять, какие из них действительно требуют внимания до нового проекта, полезно периодически проводить чек-ап ключевых систем.
Он начинается с инвентаризации. Дальше каждую систему имеет смысл рассматривать по четырём направлениям: финансы, технологии, функциональность и непрерывность.
По каждому направлению система получает отдельную оценку. Вместе они позволяют сформировать общую картину состояния ИТ-ландшафта. При этом важно учитывать и критичность системы для бизнеса: одинаковая техническая проблема совершенно по-разному влияет на вспомогательный сервис и на систему, от которой зависит производство или отгрузка продукции.
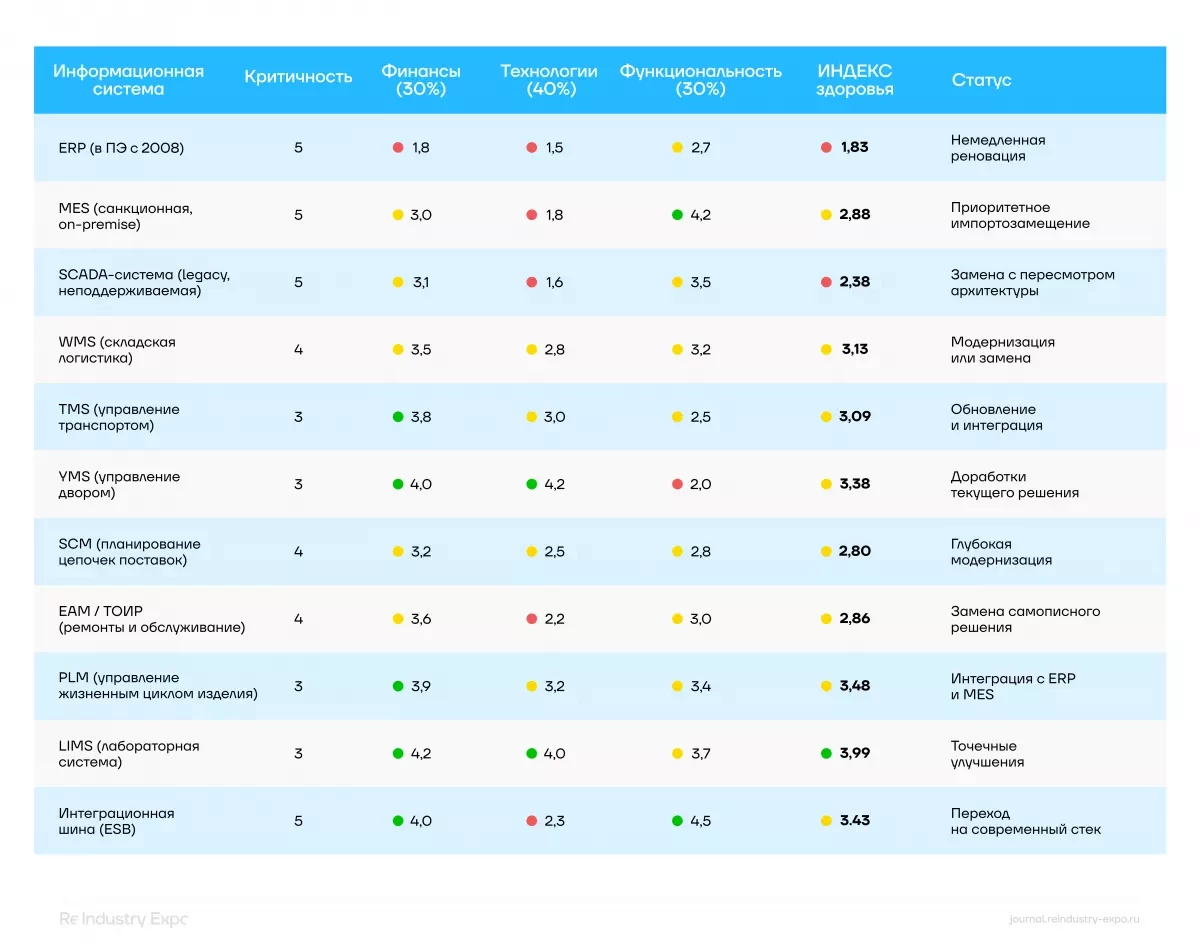
По итогам оценки для каждой системы определяют дальнейший сценарий: оставить её в текущем виде, модернизировать, консолидировать с другими решениями, заменить или вывести из эксплуатации.
Но сама оценка ещё не определяет очередность изменений. Для этого её сопоставляют с критичностью системы, зависимостями между решениями и бизнес-целями компании.
Например:
Самостоятельно воспроизвести такую оценку по одной таблице не получится: за выставленными баллами стоит обследование систем, архитектуры, фактического TCO, рисков и соответствия бизнес-процессам.
Для начала можно пройтись вместе со своей ИТ-командой по тем же четырём направлениям.
Такой базовый чек-ап, конечно, не заменит глубокого аудита, но поможет до старта нового проекта заметить очевидные ограничения и обсудить их с ИТ-командой.
Если же проблема затрагивает сразу несколько систем, непонятно, где именно находится ограничение, или необходимо выбрать между модернизацией существующего контура и новыми проектами — тогда требуется более глубокое обследование.
Ревизия ИТ-ландшафта нужна не только тогда, когда компания решила срочно сокращать расходы или затеяла масштабную трансформацию. Система может исправно работать и одновременно быть слишком дорогой, плохо восстанавливаться после сбоя, дублировать другое решение или уже не соответствовать задачам бизнеса.
Поэтому вопрос о состоянии существующего ИТ стоит задавать до того, как утверждён бюджет следующего проекта, а не после возникновения проблемы. Если по критичной системе компания не может уверенно ответить, сколько она действительно стоит, насколько нужна бизнесу и как будет восстановлена после серьёзного сбоя, — это уже повод уточнить её роль в ИТ-ландшафте.
В условиях ограниченных бюджетов задача не в том, чтобы любой ценой тратить на ИТ меньше. Гораздо важнее понимать, за что компания уже платит, какие риски при этом принимает и куда стоит вложить следующий рубль, чтобы он дал бизнесу максимальный эффект.
© КСЛ Экспо, 2026